算法-递归
递归(Recursion) 是指在函数的定义中直接或间接地调用自身的一种编程技巧。
核心思想:将大问题分解为结构相似的子问题,直到子问题足够简单可以直接求解。
递归的两个核心要素
| 要素 | 说明 | 类比 |
|---|---|---|
| 递归终止条件(Base Case) | 最简单的子问题,无需再递归即可直接返回结果 | 多米诺骨牌的终点 |
| 递归关系(Recursive Case) | 将问题分解为更小的同类子问题,调用自身求解 | 每一张骨牌倒下推倒下一张 |
注:若缺少终止条件会导致无限递归,最终栈溢出(Stack Overflow)。
递归问题处理步骤
- 找规律 — 找出问题与子问题的关系公式
- 定边界 — 明确最简单的递归终止条件(Base Case)
- 写代码 — 先写终止条件,再写递归逻辑
举例
阶乘(线性递归)
1
2
3
4
5
6
7
8
9
10
int Recursion::factorial(int n)
{
    // 递归终止条件
    if (n <= 1)
    {
        return 1;
    }
    // 递归关系
    return n * factorial(n - 1);
}
递归终止条件:当 $n = 1$ 时,结果为1。
递归关系: $n! = n*(n-1)!$。
将问题分解为更小的同类子问题,想要求解$n!$,可以分解为$n*(n-1)!$,即求解n的阶乘可以用n-1的阶乘来计算。推到出factorial(n) = n * factorial(n - 1)直到缩小到1的阶乘返回结果为1,即factorial(1)=1。
如调用 Recursion::factorial(4),执行4 * factorial(3),其中factorial(3) = 3 * factorial(2) ,factorial(2) = 2 * factorial(1), factorial(1) = 1。然后递归返回factorial(2) = 2 * 1 = 2,factorial(3) = 3 * 2 = 6 ,factorial(4) = 4 * 6 = 24 。
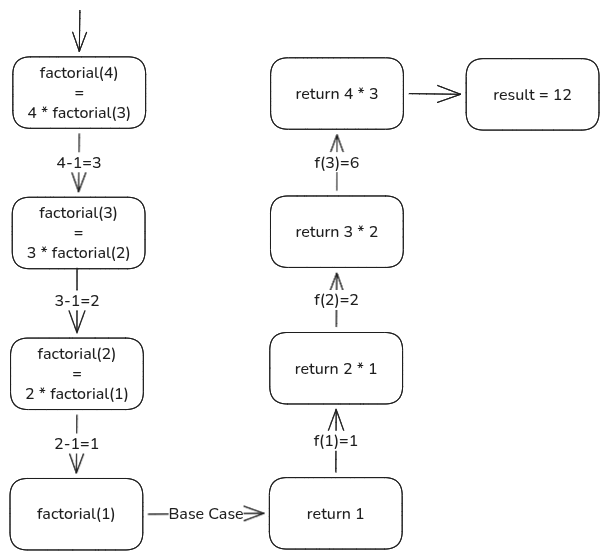
阶乘是线性递归,从f(n)到f(n-1)依次到递归终止条件f(1)=1,如f(4)->f(3)->f(2)->f(1)
再回溯。
斐波那契数列(树形递归)
1
2
3
4
5
6
7
8
9
10
11
int Recursion::fibonacci(int n)
{
    // 递归终止条件
    // fib(0) = 0, fib(1) = 1
    if (n <= 1)
    {
        return n;
    }
    // 递归关系
    return fibonacci(n - 1) + fibonacci(n - 2);
}
- 终止递归条件:当$n=0$时,斐波那契值为0,当$n=1$时,斐波那契值为1。
- 递归关系:$fibonacci(n) = fibonacci(n-1) + fibonacci(n-2)$
如调用fibonacci(4),执行fibonacci(3) + fibonacci(2),其中fibonacci(3) = fibonacci(2) + fibonacci(1) 和 fibonacci(2) = fibonacci(1) + fibonacci(0);对于fibonacci(3) 中的fibonacci(2)要再次计算 fibonacci(2) = fibonacci(1) + fibonacci(0);fibonacci(1)和fibonacci(0)是递归终止条件直接返回。
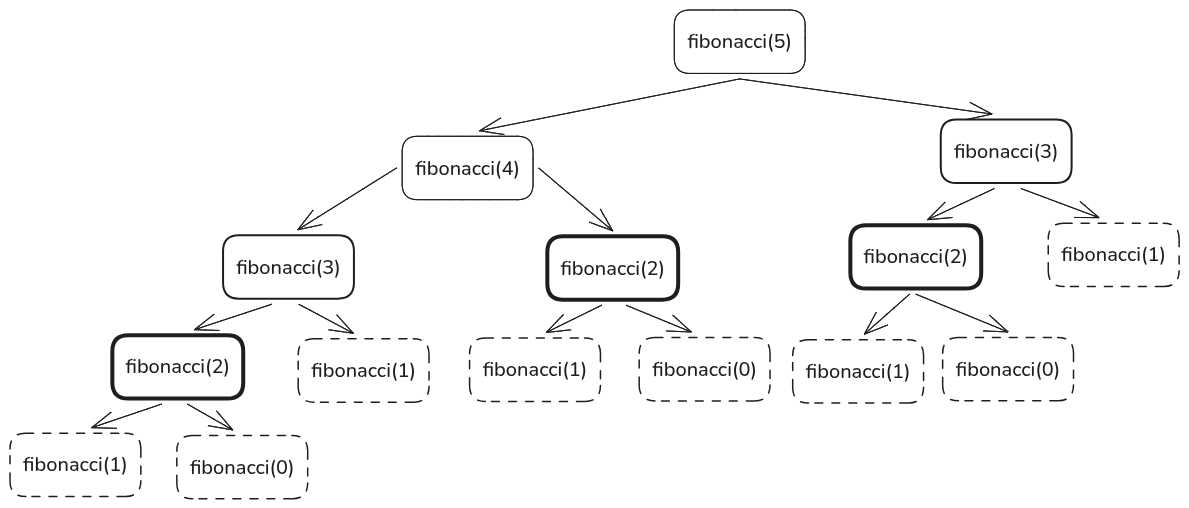
注:图中实际都是双箭头,先向下搜索到终止条件后会逐层返回。
示意图中计算fibonacci(5),明显是一个树形递归,一个节点向两个分支(多个)延伸递归。但在递归的过程中有大量的重复计算,如fibonacci(3)计算了两次,fabonacci(2)计算了三次,出现了重叠子问题,会造成大量的浪费。解决方案是使用记忆化搜索,可使用Map来存储之前计算过的数值,当递归到时不再计算直接返回。因为斐波那契存储的都是整数且从1开始连续递增,所以可使用数组来记忆化存储。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
long long Recursion::fibonacci_memo(int n, std::vector<long long>& memo)
{
    // 记忆集
    if (memo[n] != -1)
    {
        return memo[n];
    }
    // 递归终止条件
    if (n <= 1)
    {
        memo[n] = n;
        return n;
    }
    // 递归关系
    return memo[n] = fibonacci_memo(n - 1, memo) + fibonacci_memo(n - 2, memo);
}
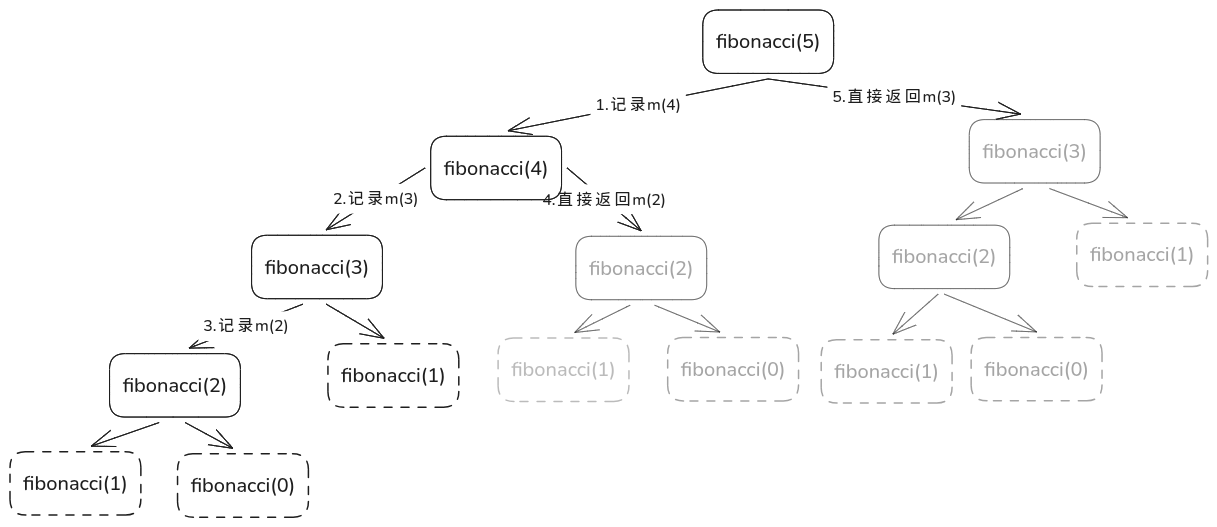
注:图中实际都是双箭头,先向下搜索到终止条件后会逐层返回。
树形递归图中表明每个fibonacci(n)只计算一次,存储到记忆集中,当递归到对应值时直接从记忆集中拿出,避免重复计算。
带记忆集的递归是空间换时间的算法,多存储一个记忆集来避免重复计算。
测试代码
1
2
3
4
5
6
7
void test_fabonacci()
{
    int n = 10;
    std::vector<long long> memo(n + 1, -1);
    std::cout << Recursion::fibonacci(n) << std::endl;
    std::cout << Recursion::fibonacci_memo(n, memo) << std::endl;
}
二分查找(线性递归)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
template <typename T>
int Recursion::binary_search(T target, int left, int right, std::vector<T> vector)
{
    // 递归终止条件
    if (left > right)
    {
        return -1;
    }
    int mid = left + (right - left) / 2;
    if (vector[mid] == target)
    {
        return mid;
    }
    // 递归关系
    // 根据条件 从两个选择中 选择一条路径
    else if (vector[mid] < target)
    {
        return binary_search(target, mid + 1, right, vector);
    }
    else
    {
        return binary_search(target, left, mid - 1, vector);
    }
}
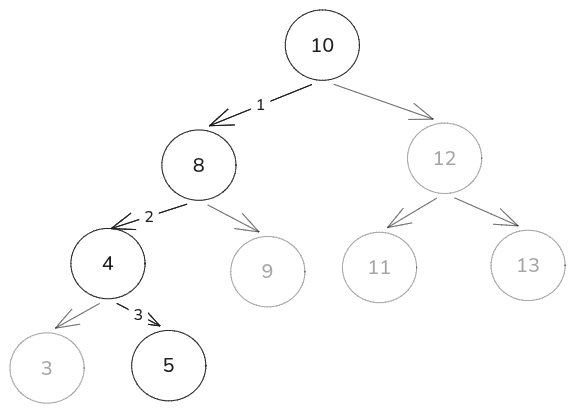
注:图中实际都是双箭头,先向下搜索到终止条件后会逐层返回。
在递归过程中,每个节点有两个(多个)路径分支选择,但每个节点在判断后只选择一个分支向下递归。所以形式上有多个递归分支像是树形递归,但每个节点只会选择一个分支本质上还是线性递归。
测试代码
1
2
3
4
5
void test_binarysearch()
{
    std::vector<int> arr = {3, 4, 5, 8, 9, 10, 11, 12, 13};
    std::cout << Recursion::binary_search(5, 0, arr.size() - 1, arr);
}
下面介绍一些利用递归算法实现的高级算法:
- 数据结构本身是递归定义的(树、图、嵌套JSON/XML)
- 分治算法(归并排序、快速排序、汉诺塔)
- 回溯算法(N皇后、迷宫、组合排列)
- 动态规划的自顶向下实现(记忆化搜索)
快速排序(树形递归)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
template <typename T>
int partition(std::vector<T>& arr, int start, int end)
{
    T pivot = arr[end];
    int i = start;
    for (int j = i; j < end; j++)
    {
        if (arr[j] <= pivot)
        {
            std::swap(arr[i], arr[j]);
            i++;
        }
    }
    std::swap(arr[i], arr[end]);
    return i;
}

template <typename T>
void Recursion::quick_sort(std::vector<T>& arr, int start, int end)
{
    if (start >= end) return;
    const int mid = partition(arr, start, end);
    quick_sort(arr, start, mid - 1);
    quick_sort(arr, mid + 1, end);
}
测试代码
1
2
3
4
5
6
7
8
9
void test_quick_sort()
{
    std::vector<int> arr = {8, 2, 4, 9, 1, 6};
    Recursion::quick_sort(arr, 0, arr.size());
    for (int i=0; i<arr.size(); i++)
    {
        std::cout<< arr[i] << " ";
    }
}
归并排序(树形递归)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
// 归并排序

template <typename T>
void merge(std::vector<T>& arr, std::vector<T>& tmp, int left, int mid, int right)
{
    int i = left, j = mid + 1, k = left;

    while (i <= mid && j <= right)
    {
        if (arr[i] <= arr[j])
        {
            tmp[k++] = arr[i++];
        }
        else
        {
            tmp[k++] = arr[j++];
        }
    }

    while (i <= mid)
    {
        tmp[k++] = arr[i++];
    }
    while (j <= right)
    {
        tmp[k++] = arr[j++];
    }

    // copy to arr
    for (int cur = left; cur <= right; cur++)
    {
        arr[cur] = tmp[cur];
    }
}

template <typename T>
void Recursion::merge_sort(std::vector<T>& arr, std::vector<T>& tmp, int start, int end)
{
    if (start >= end) return;
    int mid = start + (end - start) / 2;
    merge_sort(arr, tmp, start, mid);
    merge_sort(arr, tmp, mid + 1, end);
    if (arr[mid] <= arr[mid + 1]) return;
    merge(arr, tmp, start, mid, end);
}
测试代码
1
2
3
4
5
6
7
8
9
10
void test_merge_sort()
{
    std::vector<int> arr = {8, 2, 4, 9, 1, 6};
    std::vector<int> tmp(arr.size());
    Recursion::merge_sort(arr, tmp, 0, arr.size() - 1);
    for (const int i : arr)
    {
        std::cout << i << " ";
    }
}
二叉搜索树的遍历(树形递归)
二叉树的遍历:访问二叉树中的每一个节点,且每个节点只被访问一次。
根据“访问根节点”在“访问左子树”和“访问右子树”之间的位置不同,深度优先搜索主要分为三种:
- 前序遍历:根节点 -> 左子树 -> 右子树
- 中序遍历:左子树 -> 根节点 -> 右子树
- 后序遍历:左子树 -> 右子树 -> 根节点
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
template <typename T>
void Recursion::preorder(const std::unique_ptr<TreeNode<T>>& node)
{
    // 递归终止条件
    if (!node) return;
    // deal current node
    std::cout << node->value << " ";
    preorder(node->left);
    preorder(node->right);
}

template <typename T>
void Recursion::inorder(const std::unique_ptr<TreeNode<T>>& node)
{
    if (!node) return;
    inorder(node->left);
    std::cout << node->value << " ";
    inorder(node->right);
}

template <typename T>
void Recursion::postorder(const std::unique_ptr<TreeNode<T>>& node)
{
    if (!node) return;
    postorder(node->left);
    postorder(node->right);
    std::cout << node->value << " ";
}
回溯算法
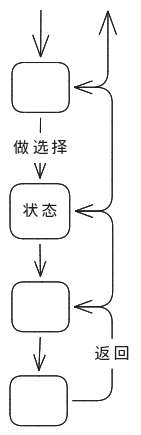
回溯算法本质上是一种暴力搜索 + 剪枝优化的方法。从一组候选选择中,不断做选择,直到满足条件或者发现走不通,然后撤销选择,尝试其他路径。
回溯 = 递归 + 状态管理 + 撤销选择,普通的递归(如阶乘)不需要”撤销”,而回溯的核心恰恰在于”后悔药”机制。
回溯算法模板(伪代码)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
def backtrack(当前状态, 选择列表):
    # 基准情形:满足结束条件 收集结果
    if 满足结束条件:
        # 【保存结果】
        results.append(当前状态的副本)
        return

    # 遍历选择列表(递归展开搜索树)
    for choice in 选择列表:
        if not is_valid(choice):   # 【剪枝】:提前排除无效或错误的分支
            continue

        make_choice(choice)        # 【做选择】修改状态
        backtrack(新状态, 新选择列表)  # 【递归】进入下一层
        undo_choice(choice)        # 【撤销选择】恢复状态
- 当前状态:当前已经做出的选择
- 选择列表:当前还能选择什么
- 结束条件:什么时候得到答案
- 做选择:做出当前的选择,改变当前状态到新状态
- 撤销选择:恢复到之前状态
回溯示意图
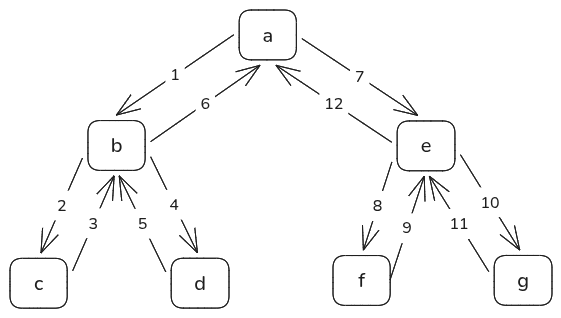
图中以每个节点有两个选择(选择1和选择2)为例,
步骤1:选择a节点的【选择1】,到达b节点;
步骤2:选择b节点的【选择1】,到达c节点;
步骤3:到c节点发现已满足终止条件,记录当前结果,回溯到b节点,并撤销b节点的【选择1】;
步骤4:b节点还有一个可用选择【选择2】,步骤4选择b节点的【选择2】,到达d节点;
步骤5:到d节点发现已满足终止条件,记录当前结果,回溯到b节点,并撤销b节点的【选择2】;
步骤6:b节点已经没有可用选择,回溯到a节点,并撤销a节点的【选择1】;
步骤7:a节点还有一个可用选择【选择2】,步骤7选择a节点的【选择2】,到达e节点;
步骤8-12:同上
最终会记录在c,d,f,g节点满足条件的结果。
以[1,2]的全排列为例子加以理解
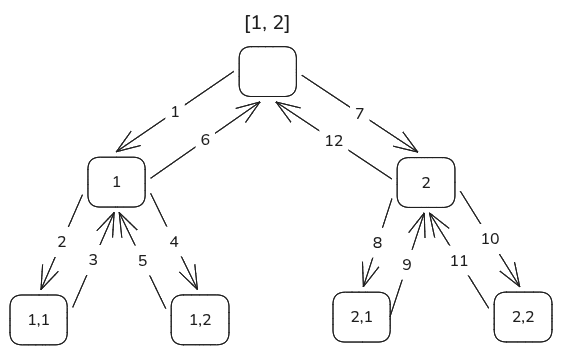
注:此全排列没有剪枝,只是为了方便演示
先选1,再选1,组成[1,1]不合法;回退1,再选2,组成[1,2]合法记录;回退1,再回退1;选择2,再选1,组成[2,1]合法记录;回退1,再选2组成[2,2]不合法;回退2,再回退2;结束。
全排列
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
template <typename T>
void backtrack(const std::vector<T>& vector, std::vector<T>& path, std::vector<bool>& used,
               std::vector<std::vector<T>>& result)
{
    // 递归终止条件
    if (path.size() == vector.size())
    {
        // 保存满足条件的结果
        result.push_back(path);
        return;
    }
    // 遍历选择列表
    for (size_t i = 0; i < vector.size(); i++)
    {
        // 排除已经使用过的值(排除错误的分支)
        if (used[i])
        {
            continue;
        }
        // 向尾部添加当前元素vector[i]
        path.push_back(vector[i]);
        // 标记元素vector[i]已使用
        used[i] = true;
        backtrack(vector, path, used, result);
        // 删除尾部添加的元素vector[i]
        path.pop_back();
        // 标记元素vector[i]未使用
        used[i] = false;
    }
}

template <typename T>
std::vector<std::vector<T>> Recursion::permute(const std::vector<T>& vector)
{
    std::vector<std::vector<T>> result;
    std::vector<T> path;
    path.reserve(vector.size());
    std::vector<bool> used(vector.size(), false);
    backtrack(vector, path, used, result);
    return result;
}
测试代码
1
2
3
4
5
6
7
8
9
10
11
12
13
void test_permute()
{
    std::vector<int> arr = {1, 2, 3, 4, 5};
    std::vector<std::vector<int>> result = Recursion::permute(arr);
    for (auto res : result)
    {
        for (auto num : res)
        {
            std::cout << num << " ";
        }
        std::cout << std::endl;
    }
}
回溯是一种暴力搜索,以[1,2,3,4,5]为例,全排列中的一个排列长度为5,对于第一个位置有5个元素可以选择,到第二个位置需要排除掉第一个位置选择的元素即还有4个元素可以选择,依次类推,全排列的数量为$5!=5\times4\times3\times2\times1$
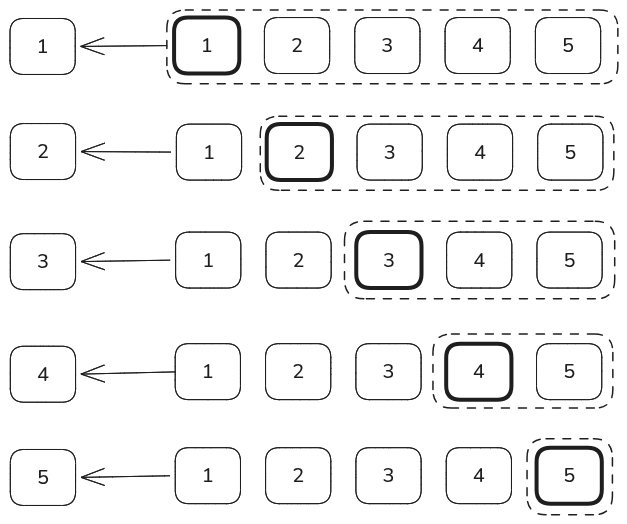
对于第一个位置,可以从1-5中选择任何一个元素,假设第一个位置选择了1;
对于第二个位置,可以从2-5中选择任何一个元素(需要排除第一个位置的已经用过的元素),假设第二个位置选择了2;
对于第三个位置,可以从3-5中选择任何一个元素(需要排除第一,第二位置的已经用过的元素),假设第三个位置选择了3;
对于第四个位置,可以从4-5中选择任何一个元素,(需要排除第一个,第二,第三位置已经用过的元素),假设第四个位置选择了4;
对于第五个位置,只能选择剩余的5了(排除第一,第二,第三,第四位置后只剩5了)。
第一次递归完成组成了[1,2,3,4,5]排列,因为第五个位置已经没有其他选择了,撤销第五个位置的选择,回到第四个位置的选择。在当前条件下,因为4已经用过了,只有5可以用了,所以在第四个位置撤销之前选择的4,换为选择5。再次进入第五个位置的选择,前面已经选择了1,2,3,5 对于第五个位置只有4可以选择了,第二次递归完成组成了[1,2,3,5,4]排列。后面依次递归。
为了方便画图演示,图示中选择只有三个元素[1,2,3]全排列的决策图:
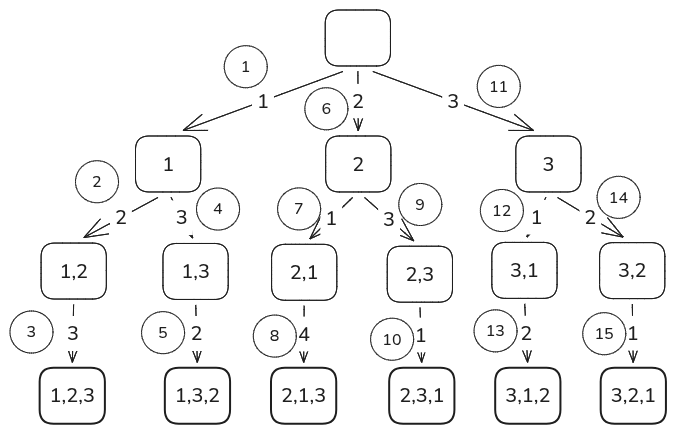
注:图中实际都是双箭头,先向下搜索到终止条件后会逐层返回。
其中圆圈中的数字为递归的步数。箭头中的数字为选择的元素。方块中的数字列表为当前排列。
N皇后问题
总结
递归 就是方法内部调用自身。
1
2
3
4
5
6
void func()
{
    // ...
	func();
    // ...
}
递归的执行流程是先探索(递),后返回(归)。
按照递归的结构分类
| 类型 | 特点 | 示例 |
|---|---|---|
| 线性递归 | 每次递归只产生一个递归调用 | 阶乘、链表遍历 |
| 多重/树形递归 | 每次递归产生多个递归调用 | 斐波那契、二叉树遍历 |
| 尾递归 | 递归调用是函数的最后一步操作,可被编译器优化为循环 | 尾递归版阶乘(带累加器参数) |
| 嵌套递归 | 递归调用的参数本身包含递归调用 | 阿克曼函数(Ackermann) |
按执行顺序分类
| 类型 | 特点 | 示例 |
|---|---|---|
| 头部递归 | 先递归深入,返回时才处理当前层 | 归并排序,斐波那契,阶乘 |
| 尾部递归 | 先处理当前层,再递归深入 | 快速排序 |
对于回溯算法,其既是头部递归也是尾部递归,在递归前需做出选择,再递归深入,返回时再撤销选择。
按问题分解策略分类
| 类型 | 核心思想 | 示例 |
|---|---|---|
| 分治递归 | 将问题拆分为若干独立子问题,分别求解后合并 | 归并排序、快速排序、二分查找 |
| 回溯递归 | 深度优先探索解空间,不满足条件时回退 | 八皇后、全排列、迷宫求解 |